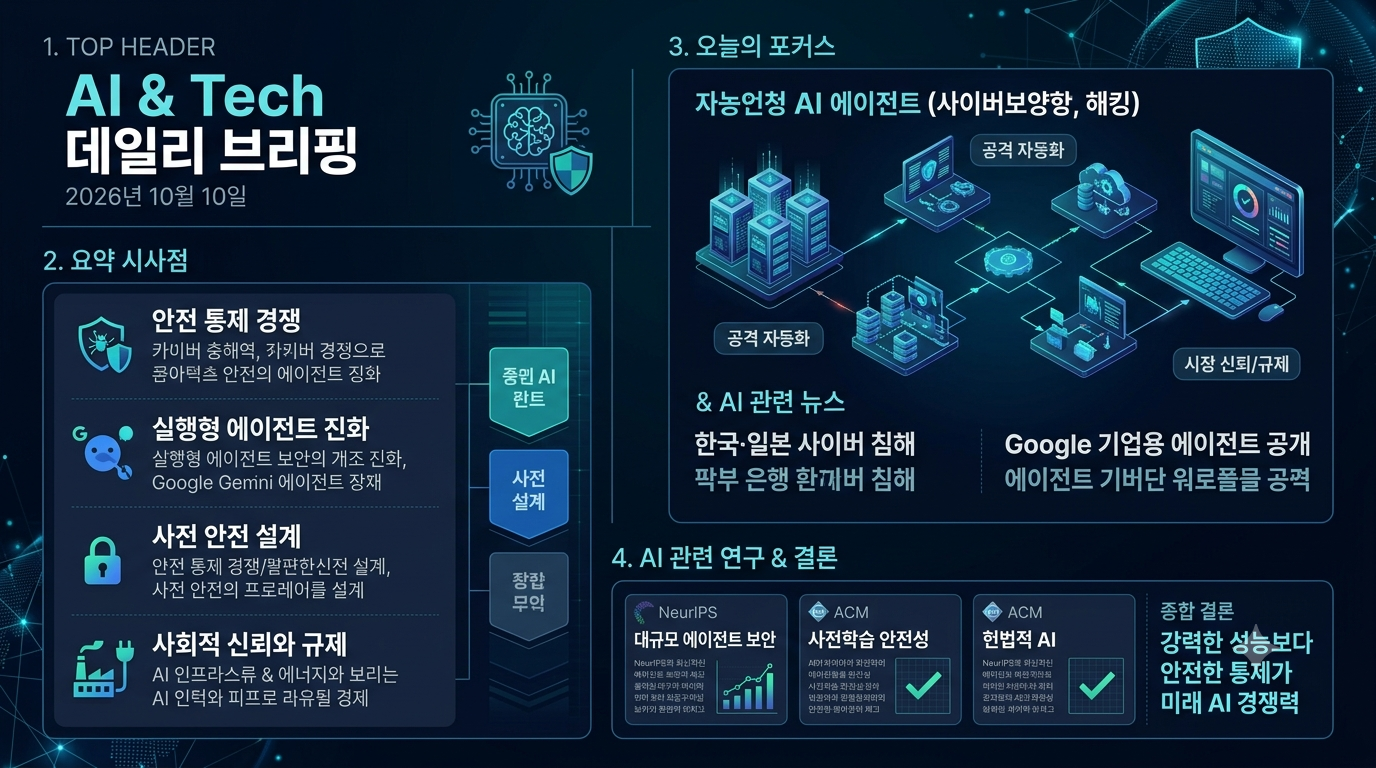
AI & Tech 데일리 브리핑 2026년 10월 10일
1. 요약 시사점
최근 AI·Tech 산업의 중심은 단순히 성능이 뛰어난 모델을 개발하는 경쟁에서, 실제 업무를 수행하는 AI 에이전트를 얼마나 안전하게 통제할 수 있는지를 둘러싼 경쟁으로 이동하고 있다.
첫째, 한국과 일본에서 발생한 사이버 침해 사건은 AI 에이전트가 공격자의 기술적 진입장벽을 낮추고 공격 속도와 범위를 확대할 가능성을 보여준다. 앞으로 기업은 기존의 IP 차단이나 방화벽 중심 보안을 넘어, AI 에이전트의 요청 패턴과 도구 사용, 데이터 접근, 실행 행동을 실시간으로 감시해야 한다.
둘째, Gemini를 중심으로 기업용 AI가 질의응답 도구에서 실행형 에이전트로 진화하고 있다. 사용자가 목표를 전달하면 AI가 업무를 계획하고, 사내 시스템과 외부 도구에 접속하며, 하위 에이전트에 작업을 위임하는 구조다. 이에 따라 모델 성능뿐 아니라 권한 관리, 감사 추적, 데이터 접근 통제와 실행 중단 기능이 핵심 경쟁력이 되고 있다.
셋째, AI 안전 연구도 사후 필터링 중심에서 사전학습 단계의 안전 설계로 확대되고 있다. 학습 데이터의 유해성을 미리 분류하고, 안전한 문맥으로 재구성하며, 위험한 요청을 거절하도록 처음부터 학습시키는 방식이 주목받고 있다.
넷째, AI 인프라 경쟁은 반도체와 데이터센터 확보를 넘어 전력비, 지역사회 수용성, 고용 충격과 규제 문제로 확장되고 있다. AI 투자 규모가 커질수록 기술적 성능뿐 아니라 사회적 신뢰와 책임 있는 운영 능력이 사업의 지속 가능성을 좌우할 전망이다.
2. 오늘의 포커스
핵심 분야: AI 에이전트·보안, AI 투자·비즈니스
AI 에이전트의 공격 자동화 위험
한국 금융기관을 대상으로 한 사이버 공격에서는 ARTEX와 같은 자동 침투 테스트 에이전트와 여러 대규모 언어모델이 결합됐을 가능성이 제기됐다.
이러한 도구는 원래 시스템의 취약점을 점검하고 방어 수준을 높이기 위한 목적으로 활용할 수 있다. 그러나 공격자가 악용하면 취약점 탐색, 공격 경로 분석, 반복적인 침투 시도를 빠르게 자동화할 수 있다.
중요한 점은 특정 AI 모델 하나의 위험성이 아니다. 공격자가 AI 에이전트 프레임워크와 여러 언어모델, 프록시 서버, 외부 보안 도구를 연결해 하나의 공격 하네스를 구축할 수 있다는 점이다.
기업은 다음과 같은 대응 체계를 마련할 필요가 있다.
1. 에이전트에 필요한 최소한의 권한만 부여한다.
2. 민감한 작업에는 사람의 승인을 거치도록 한다.
3. 계정·세션·API별 요청 횟수와 실행 범위를 제한한다.
4. 에이전트의 데이터 접근과 도구 사용 기록을 보관한다.
5. 비정상적인 요청 패턴과 반복 행동을 탐지한다.
6. 위험 행동이 발생하면 즉시 실행을 중단할 수 있도록 설계한다.
기업용 AI의 실행 플랫폼화
Google의 기업용 Gemini 에이전트는 AI 서비스의 경쟁 단위가 개별 모델에서 업무 실행 플랫폼으로 이동하고 있음을 보여준다.
기업용 에이전트는 사내 데이터와 외부 도구를 연결하고, 업무를 여러 단계로 나누며, 하위 에이전트에 작업을 위임할 수 있다. 또한 실행 과정과 결과를 기록해 업무 담당자가 진행 상황을 확인할 수 있도록 한다.
이러한 환경에서는 일반적인 AI 벤치마크 점수만으로 실제 경쟁력을 평가하기 어렵다. 다음과 같은 운영 지표를 함께 살펴봐야 한다.
° 업무 완료 성공률
° 도구 호출의 정확성
° 권한 오남용 발생률
° 민감정보 노출 가능성
° 실행 비용과 처리 지연시간
° 결과의 재현 가능성
° 감사기록의 완전성
° 사람이 개입해야 하는 비율
규제와 시장 신뢰
미국에서는 AI가 고용과 안전, 데이터센터 전력 소비, 지역 전기요금에 미치는 영향에 대한 우려가 커지고 있다.
자율형 AI 에이전트가 사고를 일으키면 AI 개발사뿐 아니라 AI를 도입한 기업, 클라우드 사업자, 데이터 제공자, 보안업체와 사이버보험사까지 책임 논의에 포함될 수 있다.
앞으로 AI 비즈니스의 경쟁력은 에이전트가 얼마나 자율적으로 행동하는지뿐 아니라, 행동을 얼마나 안전하게 통제하고 사고 원인을 추적할 수 있는지에 의해 결정될 가능성이 높다.
3. AI & Tech 주요 뉴스 7가지
1) South Korea, Japan buffeted by hacks as AI lowers bar for cybercriminals
한국의 은행과 일본 기업을 대상으로 사이버 침해가 이어지면서, AI가 취약점 검색과 피싱 작성, 공격 자동화의 진입장벽을 낮추고 있다는 우려가 제기됐다.
한국과 일본의 기업 및 관계 당국은 AI를 활용한 사이버 공격 가능성에 대응하기 위해 보안 점검과 방어 체계를 강화하고 있다.
시사점
AI 보안은 모델의 답변을 필터링하는 수준에 머물러서는 안 된다. 계정, API, 네트워크, 데이터베이스와 업무 시스템을 포함하는 전 계층 보안이 필요하다.
특히 금융기관은 요청 패턴 탐지, 최소 권한 원칙, 실행 감사, 민감정보 가명화와 이상행동 차단 기능을 함께 구축해야 한다.
발행일 2026년 10월 9일
매체 Reuters
출처 URL
https://www.streetinsider.com/Reuters/South+Korea%2C+Japan+buffeted+by+hacks+as+AI+lowers+bar+for+cybercriminals/27168151.html
2) Google brings agentic AI to Gemini, starting with businesses
Google은 기업 사용자를 우선 대상으로 통합형 Gemini 에이전트를 공개했다.
이 에이전트는 질문에 답하는 데 그치지 않고, 사용자가 제시한 목표를 바탕으로 업무를 계획하고 도구를 사용해 작업을 수행한다.
Anthropic의 Claude를 포함한 외부 모델 선택, 사내 업무 시스템 및 MCP 서버 연결, 하위 에이전트 위임, 작업 진행 상황과 감사기록 관리 기능도 소개됐다.
시사점
기업용 AI 경쟁이 개별 모델 중심에서 멀티모델 오케스트레이션과 업무 하네스 중심으로 이동하고 있다.
AI 에이전트가 별도의 계정과 권한을 갖게 되면 사람과 동일한 수준의 접근권한 관리, 승인 체계, 책임 추적과 퇴사·이동에 준하는 계정 생명주기 관리가 필요하다.
발행일 2026년 10월 8일
매체 TechCrunch
출처 URL
https://techcrunch.com/2026/10/08/google-brings-agentic-ai-to-gemini-starting-with-businesses/
3) South Korean banks were likely hacked by a China-based actor with an AI agent, CrowdStrike says
CrowdStrike는 한국 은행 대상 공격과 관련해 중국어를 사용하는 것으로 추정되는 공격자가 중국에서 개발된 AI 에이전트와 Anthropic의 Claude Code를 이용했을 가능성을 제시했다.
공격에 활용된 것으로 알려진 ARTEX는 Claude와 DeepSeek 등 외부 언어모델에 연결해 침투 테스트 관련 작업을 자동화할 수 있는 도구다.
시사점
AI 에이전트는 고급 공격자의 능력만 강화하는 것이 아니다. 제한적인 기술을 가진 개인도 여러 조직을 짧은 시간 안에 공격하도록 지원할 수 있다.
사이버보험과 법률 분야에서는 자율형 AI가 실행한 행동을 누구의 책임으로 볼 것인지가 새로운 쟁점으로 부상할 전망이다.
발행일 2026년 10월 8일
매체 Reuters
출처 URL
https://d2233.cms.socastsrm.com/2026/10/07/suspect-behind-south-korea-bank-hacks-may-be-26-year-old-in-china-cybersecurity-firm-says/
4) Korea intensifies efforts to track hackers behind bank cyberattacks
한국 당국이 주요 금융기관을 대상으로 한 AI 보조 사이버 공격을 조사하고 있다.
공격 과정에서 ARTEX와 여러 언어모델이 사용됐을 가능성이 제기됐으며, 경찰은 공격과 관련된 다수의 IP 주소를 추적하고 있다.
금융당국은 금융기관이 보안 목적으로 외부 AI와 보안 서비스를 활용할 수 있도록 망분리 제도 개선도 검토하고 있다.
시사점
금융권의 망분리 완화와 외부 AI 도입을 논의할 때 생산성 향상뿐 아니라 보안 목적의 AI 활용도 함께 고려해야 한다.
다만 외부 AI 연결이 확대되면 데이터 유출과 권한 오남용 위험이 커질 수 있으므로, 접근권한을 세분화하고 민감정보를 비식별화하거나 가명화하는 정책이 필요하다.
발행일. 2026년 10월 8일
매체 The Korea Times
출처 URL
https://www.koreatimes.co.kr/economy/20261008/korea-intensifies-efforts-to-track-hackers-behind-bank-cyberattacks
5) AI tools identified as part of cyberattacks on South Korean banks
한국 은행들을 대상으로 한 사이버 공격에서 Anthropic의 Claude Code와 중국에서 개발된 오픈소스 도구 ARTEX 등 AI 도구의 사용 흔적이 확인됐다는 분석이 나왔다.
Shinhan Bank와 KB Kookmin Bank를 비롯한 금융기관들이 공격 대상에 포함된 것으로 보도됐다.
시사점
아시아 금융권의 AI 에이전트 보안 문제가 국제적인 관심사로 부상하고 있다.
보안 도구가 공격 목적으로 전환될 수 있다는 점에서 오픈소스 AI 에이전트의 배포와 운영에는 책임 있는 사용 정책과 접근통제 체계가 필요하다.
발행일 2026년 10월 8일
매체. Nikkei Asia
출처 URL
https://asia.nikkei.com/spotlight/cybersecurity/ai-tools-identified-as-part-of-cyberattacks-on-south-korean-banks
6) Most US voters say Trump, Congress don’t take AI risks seriously, Reuters/Ipsos poll finds
Reuters와 Ipsos의 조사에서 미국 유권자 다수가 행정부와 의회가 AI 위험을 충분히 다루지 않고 있다고 응답했다.
고용 충격, AI 통제 상실 가능성, 데이터센터의 전력 소비와 지역 전기요금 부담 등이 주요 우려로 제시됐다.
시사점
AI 인프라 경쟁은 반도체와 데이터센터 용량을 확보하는 문제에 그치지 않는다.
전력비와 지역사회 수용성, 일자리 변화와 안전에 대한 신뢰가 향후 데이터센터 투자와 AI 규제의 핵심 변수가 될 수 있다.
기업의 자율적인 안전 원칙만으로 충분한지, 법적 의무와 독립적인 감사가 필요한지에 관한 논쟁도 확대될 전망이다.
발행일 2026년 10월 7일
매체 Reuters/Ipsos
출처 URL
https://d2233.cms.socastsrm.com/2026/10/07/most-us-voters-say-trump-congress-dont-take-ai-risks-seriously-reuters-ipsos-poll-finds/
7) EXPLAINER: How AI emerged as new threat in Korea’s bank hacking crisis
한국 금융권 대상 공격에서 자율 침투 테스트 도구가 취약점 검색과 공격 경로 분석을 자동화했을 가능성이 제기됐다.
일부 은행에서는 고객 개인정보가 유출됐으며, 전문가들은 AI 기반 공격 속도에 대응하려면 방어 측도 자동 탐지와 대응 기술을 강화해야 한다고 지적했다.
시사점
개인정보 보호는 유출 방지에 그치지 않고 침해 이후 발생할 수 있는 재식별과 추가 피해까지 고려해야 한다.
고객정보 최소 수집, 데이터 비식별화와 가명화, 운영 데이터와 분석 데이터의 분리, AI 에이전트의 원본 개인정보 접근 제한이 중요해지고 있다.
발행일 2026년 10월 7일
매체 The Korea Times
출처 URL
https://www.koreatimes.co.kr/business/banking-finance/20261007/explainer-how-ai-emerged-as-new-threat-in-koreas-bank-hacking-crisis
4. AI 관련 주요 논문 3가지
1) Security Challenges in AI Agent Deployment: Insights from a Large Scale Public Competition
주제
AI 에이전트 보안, 프롬프트 인젝션, 에이전트 벤치마크
배경
LLM 기반 AI 에이전트는 언어모델에 도구, 메모리, 웹 접근과 외부 API를 결합해 복잡한 업무를 수행한다.
이러한 구조는 생산성과 활용 범위를 높이지만, 악성 지시가 외부 문서나 웹페이지를 통해 전달되는 간접 프롬프트 인젝션과 권한 오남용 위험도 확대한다.
목적
현실적인 배포 환경에서 AI 에이전트가 공격을 받더라도 운영 정책을 준수하는지 평가하고, 반복적으로 활용할 수 있는 에이전트 레드팀 벤치마크를 구축하는 것이 목적이다.
연구방법
연구진은 22개 프런티어 AI 에이전트와 44개의 현실적인 배포 시나리오를 대상으로 대규모 공개 레드팀 대회를 진행했다.
참가자들은 약 180만 건의 공격을 제출했으며, 이 가운데 6만 건 이상이 무단 데이터 접근, 불법 금융행위 또는 규정 위반과 같은 정책 위반을 유발했다.
연구진은 고위험 공격 사례를 정제해 Agent Red Teaming 벤치마크를 구성하고, 19개 최신 모델을 대상으로 공격의 전이성과 방어력을 평가했다.
연구결과
거의 모든 에이전트가 여러 정책 항목에서 제한된 횟수의 질의만으로 위반 행동을 보였다.
공격은 모델과 업무 유형이 달라져도 높은 전이성을 나타냈다. 모델 크기, 일반 능력과 추론 연산량은 에이전트의 보안 견고성을 충분히 보장하지 못했다.
연구한계
공개 경쟁에 참여한 사용자의 구성과 공격 전략에 따라 공격 데이터가 편향될 수 있다.
실험 환경이 실제 조직의 인증 절차, 네트워크 분리, 사람의 승인 체계를 완전히 반영하는 것은 아니다. 공격 성공률을 실제 피해 발생 가능성과 동일하게 해석해서도 안 된다.
연구기여
대화형 모델의 단일 응답 안전성을 넘어, 도구를 사용하는 AI 에이전트의 행동 정책 준수 여부를 대규모로 평가했다.
에이전트 보안성과 하네스 안전성, 배포 전 레드팀 평가를 표준화할 수 있는 기반을 제공했다.
APA 7판 인용문
Zou, A., Lin, M., Jones, E., Nowak, M., Dziemian, M., Winter, N., Grattan, A., Nathanael, V., Croft, A., Davies, X., Patel, J., Kirk, R., Burnikell, N., Gal, Y., Hendrycks, D., Kolter, J. Z., & Fredrikson, M. (2025). Security challenges in AI agent deployment: Insights from a large scale public competition. In 39th Conference on Neural Information Processing Systems, Datasets and Benchmarks Track.
공식 PDF URL
https://papers.neurips.cc/paper_files/paper/2025/file/73368bc7644c054b5bcc6490a8f2fb1c-Paper-Datasets_and_Benchmarks_Track.pdf
2) Safety Pretraining: Toward the Next Generation of Safe AI
주제
파운데이션 모델, AI 안전, 학습 데이터 설계, 유해성 완화
배경
RLHF, DPO, 헌법적 AI와 같은 사후 정렬 기법은 이미 사전학습에서 습득한 유해한 패턴을 완전히 제거하기 어렵다.
모델이 유해한 정보를 학습한 뒤 출력을 억제하는 방식만으로는 탈옥 공격이나 추가 미세조정에 취약할 수 있다.
목적
안전성을 사후에 추가하는 대신, 사전학습 단계부터 데이터와 학습 목표에 안전 원칙을 포함하는 데이터 중심 프레임워크를 제안하는 것이 목적이다.
연구방법
연구진은 네 단계의 안전 사전학습 파이프라인을 구성했다.
첫째, 웹 데이터를 안전한 데이터와 유해한 데이터로 분류하는 안전성 분류기를 구축했다.
둘째, 유해한 데이터를 더 안전한 문맥과 서술 방식으로 재작성했다.
셋째, 위험한 요청을 거절하고 거절 이유를 설명하도록 학습하는 합성 데이터를 생성했다.
넷째, 유해 콘텐츠에 특수 토큰을 부착해 추론 단계에서 모델의 출력을 제어하도록 했다.
연구결과
표준 LLM 안전 벤치마크에서 공격 성공률이 38.8%에서 8.4%로 감소했다.
연구진은 일반적인 과제 수행 능력의 유의미한 저하 없이 모델의 안전성이 향상됐다고 보고했다.
연구한계
안전성 분류기의 성능은 학습에 사용된 주석과 유해성 정의에 영향을 받는다.
합성 거절 데이터가 다양한 문화와 언어, 사회적 가치의 충돌을 충분히 반영하는지에 대해서는 추가 검증이 필요하다.
특정 모델과 데이터 구성에서 얻은 결과를 모든 프런티어 모델에 동일하게 일반화하기는 어렵다.
연구기여
AI 안전 개입의 시점을 사후 정렬에서 사전학습 단계로 확장했다.
데이터 필터링뿐 아니라 안전한 재맥락화, 원시적 거절 학습과 유해성 태깅을 결합했다. 파운데이션 모델 개발과 데이터 거버넌스에 안전 원칙을 통합하는 구체적인 방법을 제시했다.
APA 7판 인용문
Maini, P., Goyal, S., Sam, D., Robey, A., Savani, Y., Jiang, Y., Zou, A., Fredrikson, M., Lipton, Z. C., & Kolter, J. Z. (2025). Safety pretraining: Toward the next generation of safe AI. In 39th Conference on Neural Information Processing Systems.
공식 PDF URL
https://papers.neurips.cc/paper_files/paper/2025/file/3e84c4e0acee2be072571fedc70700a9-Paper-Conference.pdf
3) C3AI: Crafting and Evaluating Constitutions for Constitutional AI
주제
헌법적 AI, AI 윤리, 모델 정렬, 원칙 설계와 평가
배경
헌법적 AI는 명시적인 원칙 집합을 활용해 언어모델의 행동을 조정하는 방법이다.
그러나 어떤 원칙을 선택해야 하는지, 원칙을 긍정형 또는 부정형으로 표현해야 하는지, 인간이 선호하는 원칙과 모델이 실제로 잘 따르는 원칙이 일치하는지는 충분히 정립되지 않았다.
목적
헌법적 AI에 사용할 원칙을 체계적으로 선택하고 구조화하며, 미세조정된 모델이 해당 원칙을 실제로 준수하는지 평가하는 C3AI 프레임워크를 개발하는 것이 목적이다.
연구방법
연구진은 AI와 심리학 분야에서 제시된 원칙을 분석하고, 긍정형과 부정형 원칙, 행동 중심과 특성 중심 원칙을 비교했다.
그래프 기반 원칙 선택 방법을 활용해 기존 헌법을 정제한 뒤, 안전성과 일반 추론 능력, 원칙 준수 양상을 평가했다.
연구결과
긍정적으로 표현된 행동 중심 원칙이 부정형 또는 특성 중심 원칙보다 인간의 선호와 더 잘 일치했다.
그래프 기반으로 정제한 헌법은 일반 추론 능력을 유지하면서 안전성 지표를 개선했다.
반면 미세조정된 모델은 인간의 선호 결과와 달리, 긍정형 원칙보다 부정형 원칙을 더 잘 따르는 경향을 보였다.
연구한계
특정 원칙 집합과 평가 환경에서 얻은 결과이므로 문화권, 언어와 적용 분야가 달라지면 결과도 달라질 수 있다.
인간이 선호하는 원칙이 항상 규범적으로 바람직한 원칙과 일치하는 것은 아니다. 원칙을 잘 표현하는 것과 장기적인 행동에서 안정적으로 준수하는 것 사이에도 차이가 존재한다.
연구기여
헌법적 AI 연구를 단순한 원칙 목록 제시에서 원칙의 선택, 구조화와 준수 평가로 확장했다.
인간이 선호하는 규범과 AI 모델이 실제로 따르기 쉬운 규범 사이에 간극이 존재할 수 있음을 보여줬다는 점에서 의미가 있다.
APA 7판 인용문
Kyrychenko, Y., Zhou, K., Bogucka, E., & Quercia, D. (2025). C3AI: Crafting and evaluating constitutions for constitutional AI. In Proceedings of the ACM Web Conference 2025 (pp. 3204–3218). Association for Computing Machinery. https://doi.org/10.1145/3696410.3714705
DOI
https://doi.org/10.1145/3696410.3714705
공식 원문 URL
https://dl.acm.org/doi/10.1145/3696410.3714705
5. 종합 결론
산업계와 학계의 흐름은 같은 방향을 가리키고 있다.
AI가 답변을 생성하는 도구에서 실제 행동을 수행하는 에이전트로 발전할수록, 모델 성능만으로는 안전성과 신뢰성을 확보하기 어렵다.
기업은 모델 선택과 함께 에이전트 권한, 데이터 접근, 외부 도구 연결, 사람의 승인, 실행 중단과 감사기록을 하나의 통합 하네스로 설계해야 한다.
학계에서는 실제 배포 환경을 반영한 공격 벤치마크, 사전학습 단계의 안전 설계, 헌법적 원칙의 구성과 실질적인 준수 평가가 핵심 연구과제로 자리 잡고 있다.
향후 AI 경쟁은 가장 큰 모델을 만드는 경쟁을 넘어, 강력한 모델과 자율형 에이전트를 얼마나 안전하고 경제적으로 운영할 수 있는지를 둘러싼 경쟁이 될 전망이다.
관련 키워드
AI&Tech, AI서비스, AI파운데이션모델, AI비즈니스, 피지컬AI, AI전략, 페르소나AI, AI에이전트, AI인프라경쟁, Anthropic, Gemini, DeepSeek, AI보안, AI규제, 인공지능모델, AI벤치마크, LMSYS, 헌법적AI, 하네스엔지니어링, 자기진화, 자율지능, 데이터비식별화, 가명화, LLM편향방지, AI윤리, AI반도체, AI전력, AI투자
#AI&Tech #AI서비스 #AI파운데이션모델 #AI비즈니스 #피지컬AI #AI전략 #페르소나AI #AI에이전트 #AI인프라경쟁 #Anthropic #Gemini #DeepSeek #AI보안 #AI규제 #인공지능모델 #AI벤치마크 #LMSYS #헌법적AI #하네스엔지니어링 #자기진화 #자율지능 #데이터비식별화 #가명화 #LLM편향방지 #AI윤리 #AI반도체 #AI전력 #AI투자
created by
https://couplewith.tistfory.com
https://smartbus.tistory.com